Linux nel mondo reale: server, cloud, Android e supercomputer
Scopri perché Linux è ovunque: server, cloud, container, Kubernetes, cybersecurity, Android, sistemi embedded e supercomputer. Una guida per capire dove viene usato Linux nel mondo reale.
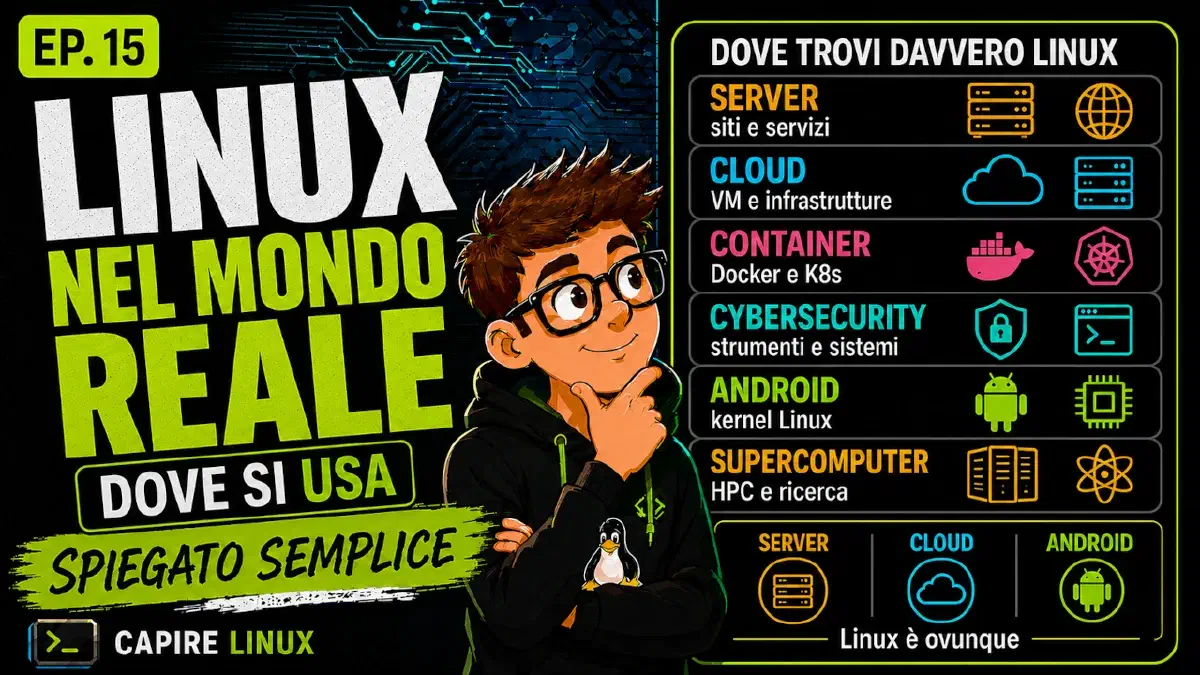
Linux viene spesso associato al terminale, ai programmatori o a chi decide di installare una distribuzione come Ubuntu, Debian, Fedora o Arch Linux sul proprio computer.
Questa visione, però, racconta soltanto una piccola parte della storia.
Linux è presente in moltissimi dei sistemi che utilizziamo ogni giorno, anche quando non ce ne accorgiamo. Lo troviamo nei server che ospitano siti e applicazioni, nelle infrastrutture cloud, nei container, nei cluster Kubernetes, nei dispositivi embedded, negli smartphone Android e nei supercomputer.
Capire Linux, quindi, non significa soltanto imparare a utilizzare un sistema operativo alternativo sul desktop. Significa comprendere una parte fondamentale dell’infrastruttura informatica moderna.
In questo articolo vediamo dove viene utilizzato Linux nel mondo reale, perché è così diffuso e in che modo concetti come processi, servizi, filesystem, rete, permessi e kernel ritornano continuamente in scenari apparentemente molto diversi.
Linux nei server: uno degli ambienti in cui esprime meglio le sue
caratteristiche
Uno dei settori in cui Linux è maggiormente utilizzato è quello dei server.
Un server è, in termini semplici, un computer che mette a disposizione un servizio ad altri sistemi o agli utenti. Può ospitare un sito web, eseguire un database, conservare file, gestire autenticazioni, offrire servizi DNS oppure eseguire applicazioni aziendali.
È proprio sui server che molti dei concetti fondamentali di Linux diventano particolarmente evidenti.
Un’applicazione installata sul sistema viene eseguita attraverso uno o più processi. Questi processi utilizzano memoria, aprono file, comunicano attraverso la rete e lavorano con determinati privilegi.
Molte applicazioni server vengono inoltre gestite come servizi. In una distribuzione moderna basata su systemd, per esempio, un server web o un database può essere avviato automaticamente all’accensione della macchina e mantenuto attivo in background.
Se qualcosa non funziona, entrano in gioco i log, il journal di systemd e gli strumenti di troubleshooting.
Un server Linux, quindi, può essere visto come la concretizzazione di molti dei concetti che abbiamo affrontato nella serie Capire Linux: processi, servizi, filesystem, permessi, memoria, networking, log e sicurezza lavorano insieme continuamente.
Perché Linux è così utilizzato sui server
Non esiste una sola ragione per cui Linux sia così diffuso nel mondo server.
Una delle caratteristiche più importanti è il controllo. Linux permette di configurare in modo molto dettagliato servizi, utenti, permessi, rete, filesystem e risorse.
A questo si aggiunge la possibilità di automatizzare molte operazioni attraverso shell, script e file di configurazione.
Un amministratore può collegarsi a un server remoto, modificare una configurazione, riavviare un servizio, verificare i log oppure controllare lo stato della rete senza avere necessariamente bisogno di un’interfaccia grafica.
La shell, che sul desktop può sembrare semplicemente un’alternativa al mouse e alle finestre, nel mondo server diventa uno strumento fondamentale.
Anche il networking svolge un ruolo centrale. Linux integra nel kernel funzioni avanzate per la gestione delle interfacce di rete, dei socket, del routing e del filtraggio dei pacchetti.
A tutto questo si aggiunge un ecosistema open source enorme, composto da server web, database, linguaggi, strumenti di automazione, sistemi di monitoraggio e piattaforme di sviluppo.
Dal server al cloud
Quando si parla di cloud computing, può sembrare che il concetto di server tradizionale sia ormai superato.
In realtà il cloud non elimina i server.
Li rende più dinamici, programmabili e distribuiti.
Alla base di un’infrastruttura cloud continuano infatti a esistere computer fisici, CPU, memoria, storage e reti. Sopra queste risorse vengono costruiti livelli di virtualizzazione e automazione che permettono di creare rapidamente macchine virtuali e servizi.
Quando creiamo una macchina virtuale nel cloud, dal nostro punto di vista stiamo spesso utilizzando qualcosa di molto simile a un normale server.
La macchina ha CPU virtuali, memoria, spazio disco, interfacce di rete e un sistema operativo. Molto frequentemente quel sistema operativo è Linux.
Per questo motivo conoscere Linux rimane estremamente utile anche nel cloud.
Cambiano gli strumenti attraverso cui creiamo le risorse, ma una volta entrati nella macchina ritroviamo processi, servizi, utenti, filesystem, log, rete e permessi.
Il cloud non sostituisce Linux. In molti scenari lo utilizza come una delle proprie fondamenta.
Linux e macchine virtuali
La virtualizzazione permette di eseguire più sistemi operativi sulla stessa macchina fisica.
Ogni macchina virtuale può avere un proprio kernel, una propria memoria virtuale, un proprio filesystem e delle interfacce di rete virtuali.
Per chi amministra la macchina, però, l’esperienza può essere quasi identica a quella di un server fisico.
Possiamo collegarci tramite SSH, installare pacchetti, configurare servizi, creare utenti e analizzare i log.
Questo è uno dei motivi per cui le competenze Linux sono così trasferibili.
Che il server si trovi sotto la nostra scrivania oppure in un data center distante migliaia di chilometri, il modello concettuale rimane spesso lo stesso.
Container Linux: non sono semplicemente piccole macchine virtuali
Il mondo del cloud moderno è strettamente legato anche ai container.
Docker ha contribuito enormemente alla loro diffusione, tanto che spesso si parla di container e Docker quasi come fossero sinonimi.
Dal punto di vista architetturale, però, è importante capire una distinzione fondamentale.
Un container non è semplicemente una piccola macchina virtuale.
Una macchina virtuale dispone normalmente di un proprio sistema operativo e di un proprio kernel.
I container, invece, possono condividere il kernel del sistema host.
L’isolamento viene costruito attorno ai processi.
Un processo all’interno di un container può vedere un proprio filesystem, una propria configurazione di rete e un proprio insieme di processi. Può inoltre avere limiti specifici sulle risorse disponibili.
Dietro questo modello troviamo meccanismi del kernel Linux come namespace e cgroups.
I namespace contribuiscono a isolare la visione che i processi hanno del sistema, mentre i control groups permettono di controllare e contabilizzare risorse come CPU e memoria.
Questo significa che i container non rappresentano qualcosa di completamente separato da Linux.
Sono invece costruiti utilizzando molte funzionalità offerte dal kernel.
Perché capire Linux aiuta a capire Docker
Quando utilizziamo Docker vediamo soprattutto immagini, container, volumi e reti.
Ma quando qualcosa non funziona, spesso bisogna scendere di livello.
Un container non riesce ad accedere a un file?
Potrebbe esserci un problema di permessi.
Un’applicazione non riesce a comunicare?
Potrebbe essere necessario osservare networking, porte e socket.
Un container viene terminato perché consuma troppe risorse?
Entrano in gioco memoria e limiti.
Un processo non parte?
Dobbiamo tornare al funzionamento dei processi e dell’ambiente in cui viene eseguito.
Conoscere Linux permette quindi di comprendere meglio ciò che Docker cerca di semplificare.
Kubernetes: quando i container diventano un’infrastruttura
Un singolo container è relativamente semplice da gestire.
Il problema cambia completamente quando i container diventano centinaia o migliaia e vengono distribuiti su molte macchine.
Qualcuno deve decidere dove eseguire i workload, cosa fare quando un container termina, come mantenere attivo il numero desiderato di istanze e come permettere ai componenti di comunicare tra loro.
È in questo scenario che entra in gioco Kubernetes.
Kubernetes è una piattaforma per l’orchestrazione di applicazioni containerizzate.
L’idea fondamentale è descrivere lo stato desiderato dell’infrastruttura.
Possiamo, per esempio, dichiarare che una determinata applicazione deve avere tre istanze disponibili.
Kubernetes cercherà di mantenere quello stato.
Se un’istanza termina, può crearne un’altra.
Se un nodo non è disponibile, il carico può essere spostato altrove.
Kubernetes introduce concetti propri come Pod, Deployment, Service e scheduler, ma sotto questa struttura continuano a esistere macchine, container runtime, processi, filesystem, networking e kernel.
L’orchestrazione aggiunge un nuovo livello. Non sostituisce le fondamenta Linux.
Lo scheduler Linux e lo scheduler Kubernetes non sono la stessa cosa
Il termine scheduler compare sia nel kernel Linux sia in Kubernetes, ma indica due problemi differenti.
Lo scheduler del kernel Linux decide come distribuire il tempo della CPU tra i processi.
Lo scheduler Kubernetes decide invece su quale nodo del cluster collocare un determinato Pod.
Sono livelli completamente diversi, ma il principio generale è interessante.
In entrambi i casi esistono risorse limitate e attività che devono essere eseguite.
Serve quindi un componente che decida come utilizzare quelle risorse.
Comprendere questo parallelismo aiuta a vedere come alcuni concetti informatici ricompaiano a scale differenti.
Linux e cybersecurity
Linux è estremamente importante anche nella cybersecurity.
Spesso questo rapporto viene ridotto a distribuzioni specializzate come Kali Linux, ma la realtà è molto più ampia.
Linux è innanzitutto uno dei sistemi che devono essere protetti.
Se dobbiamo mettere in sicurezza un server Linux dobbiamo conoscere utenti, gruppi, permessi, processi, servizi, rete e log.
Dobbiamo sapere quali servizi sono esposti, quali porte sono aperte, con quali privilegi vengono eseguiti i processi e dove vengono registrati gli eventi.
Gli stessi concetti diventano fondamentali durante un incidente di sicurezza.
Un analista potrebbe dover capire quale processo ha effettuato una determinata connessione, quali file sono stati modificati, con quale utente è stata eseguita un’operazione oppure quale servizio è stato compromesso.
Linux è quindi contemporaneamente un sistema da proteggere e uno strumento utilizzato per svolgere attività di cybersecurity.
La sicurezza parte dalla conoscenza del sistema operativo
Studiare cybersecurity senza comprendere il funzionamento di un sistema operativo crea inevitabilmente delle lacune.
Prima di utilizzare strumenti avanzati è importante sapere che cosa sia un processo, come funzionino utenti e privilegi, cosa rappresenti una porta di rete e dove cercare i log.
Questo vale anche per il troubleshooting e l’incident response.
Quando osserviamo qualcosa di anomalo, le prime domande sono spesso molto semplici.
Quale processo sta generando il traffico?
Con quale utente viene eseguito?
Quali privilegi possiede?
Quali file ha aperto?
Quale servizio lo ha avviato?
Cosa registrano i log?
Sono domande che richiedono prima di tutto una buona comprensione di Linux e dei sistemi operativi.
Linux nei dispositivi embedded
Linux non vive soltanto nei server e nei grandi data center.
Può essere utilizzato anche in dispositivi molto più piccoli e specializzati.
Router, NAS, Smart TV, dispositivi industriali, sistemi automotive e prodotti IoT possono utilizzare il kernel Linux come base del proprio sistema.
Naturalmente questo non significa che ogni dispositivo di queste categorie utilizzi Linux.
Il punto importante è un altro: Linux può essere adattato a sistemi con caratteristiche estremamente differenti.
Un dispositivo embedded può avere poca memoria, storage limitato e nessun ambiente desktop.
In questi casi è possibile costruire uno user space ridotto contenente soltanto ciò che serve.
Il sistema può includere il kernel, i driver necessari, alcune librerie, pochi servizi e l’applicazione principale del dispositivo.
Tutto ciò che non serve può essere eliminato.
Questa capacità di adattamento è una delle caratteristiche più interessanti dell’ecosistema Linux.
Android usa il kernel Linux
Uno degli esempi più importanti di sistema basato sul kernel Linux è Android.
Android utilizza un kernel derivato dal kernel Linux per gestire processi, memoria, networking, driver e accesso all’hardware.
Questo non significa però che Android sia semplicemente una distribuzione Linux come Ubuntu o Debian con una diversa interfaccia grafica.
Sopra il kernel Android utilizza un proprio user space, un framework applicativo specifico e un modello software progettato per smartphone, tablet e altri dispositivi.
La distinzione è fondamentale.
Linux è il kernel.
Intorno al kernel possono essere costruiti sistemi operativi molto diversi.
Ubuntu, un server minimale, un dispositivo embedded e Android possono condividere alcune fondamenta senza essere lo stesso sistema.
Kernel Linux e user space
Questa distinzione tra kernel e user space è probabilmente una delle idee più importanti per comprendere perché Linux riesca a comparire in contesti così diversi.
Il kernel gestisce le risorse fondamentali della macchina.
Si occupa di processi, memoria, filesystem, rete e dispositivi.
Sopra di esso possiamo costruire ambienti completamente differenti.
Su un computer desktop avremo un ambiente grafico, applicazioni, browser e strumenti per l’utente.
Su un server potremmo avere soltanto servizi e una shell.
Su un dispositivo embedded potremmo avere una singola applicazione specializzata.
Su Android troviamo un intero framework costruito specificamente per dispositivi mobili.
La base può essere simile, ma l’esperienza finale cambia completamente.
Linux nei supercomputer
All’estremo opposto rispetto ai piccoli dispositivi embedded troviamo i supercomputer.
Questi sistemi vengono utilizzati per simulazioni scientifiche, ricerca, previsioni climatiche, fisica, medicina, ingegneria e intelligenza artificiale.
In questo scenario Linux dimostra una caratteristica particolarmente importante: la scalabilità.
Lo stesso modello di kernel che possiamo incontrare su un normale computer può essere adattato a infrastrutture enormemente più potenti e complesse.
Naturalmente un supercomputer non è semplicemente un normale PC con più memoria.
Architetture hardware, software scientifico, sistemi di storage e networking sono completamente differenti.
Ma Linux rimane una base estremamente adatta a costruire sistemi personalizzati e ad alte prestazioni.
Perché Linux riesce ad adattarsi a scenari così diversi
A questo punto possiamo tornare alla domanda fondamentale.
Perché Linux riesce a funzionare su un server, in un container, su uno smartphone, in un router e in un supercomputer?
La risposta non dipende da una singola caratteristica.
Linux è modulare, configurabile e adattabile.
Il codice del kernel è open source e può essere studiato e modificato.
Il supporto hardware è molto ampio.
Il sistema può essere automatizzato attraverso shell, script e strumenti esterni.
Il networking è integrato profondamente nell’architettura.
Il modello multiutente e dei permessi permette di separare processi e responsabilità.
Soprattutto, intorno a Linux si è sviluppato nel tempo un ecosistema software enorme.
Server, database, cloud, container, strumenti DevOps, sistemi di monitoraggio e piattaforme di sicurezza sono cresciuti insieme a questo ecosistema.
Perché imparare Linux è utile
Imparare Linux non significa necessariamente decidere di utilizzarlo come sistema operativo desktop principale.
Il valore principale sta nei concetti.
Quando impariamo cosa sia un processo, acquisiamo una conoscenza utile anche per lo sviluppo software, i container e il troubleshooting.
Quando comprendiamo filesystem e permessi, acquisiamo concetti fondamentali per l’amministrazione e la cybersecurity.
Quando studiamo rete, porte, socket e routing, stiamo costruendo conoscenze utilizzabili nei server, nel cloud e nelle architetture distribuite.
Quando impariamo la shell, acquisiamo uno strumento potente per automatizzare operazioni.
Linux diventa così un modo concreto per studiare il funzionamento dei sistemi informatici.
Dopo Capire Linux: cosa imparare
La serie Capire Linux ha avuto soprattutto un obiettivo concettuale.
Prima di memorizzare i comandi abbiamo cercato di costruire una mappa.
A questo punto il percorso può diventare più pratico.
Il primo passo naturale è imparare i comandi fondamentali della shell: navigazione nel filesystem, gestione di file e directory, ricerca del testo, processi, utenti, permessi e rete.
Successivamente si può passare all’amministrazione Linux, imparando a gestire utenti, servizi, storage, aggiornamenti, backup, firewall e sicurezza.
Un altro passaggio molto importante è Bash scripting.
Scrivere script significa trasformare sequenze di operazioni manuali in procedure automatizzate e ripetibili.
Da qui il percorso può poi proseguire verso Docker, DevOps, cloud e Kubernetes.
La differenza rispetto a partire direttamente da questi strumenti è importante.
Dopo aver compreso Linux sappiamo cosa succede sotto l’interfaccia.
Quando utilizziamo ps sappiamo che stiamo osservando processi.
Quando eseguiamo chmod sappiamo quali permessi stiamo modificando.
Quando analizziamo un container sappiamo che dietro continuano a esistere processi, filesystem, rete e risorse gestite dal kernel.
Capire Linux significa avere una mappa
Non è necessario conoscere ogni comando Linux a memoria.
Nemmeno chi lavora quotidianamente con Linux conosce ogni configurazione, ogni servizio e ogni possibile errore.
La competenza più utile è sapere come orientarsi.
Se un servizio non parte, dobbiamo sapere dove cercare informazioni.
Se riceviamo un errore di permessi, dobbiamo sapere quali elementi controllare.
Se la rete non funziona, dobbiamo riuscire a distinguere tra interfacce, indirizzi IP, routing, DNS e firewall.
Se un sistema è lento, dobbiamo sapere che esistono CPU, processi, memoria, I/O e storage da analizzare.
È proprio questa mappa mentale che permette di affrontare Linux senza considerarlo una scatola nera.
Linux nel mondo reale: dal kernel al cloud
Possiamo infine riassumere l’intero percorso con una struttura molto semplice.
Alla base troviamo l’hardware.
Sopra l’hardware lavora il kernel Linux, che gestisce processi, memoria, rete, filesystem e dispositivi.
Sopra il kernel troviamo lo user space, con librerie, utility, shell, applicazioni e servizi.
Da questi componenti possiamo costruire sistemi completamente diversi: desktop, server, infrastrutture cloud, container, cluster Kubernetes, sistemi di cybersecurity, dispositivi embedded, Android e supercomputer.
Cambiano le dimensioni e cambiano gli strumenti.
Le fondamenta, però, continuano a ritornare.
Ed è proprio questo il motivo per cui conoscere Linux rimane una competenza così utile.
Una volta compresi i livelli, Linux smette di sembrare un insieme di comandi e configurazioni misteriose.
Diventa una struttura che possiamo osservare, comprendere e, progressivamente, imparare ad amministrare.